Par Pape Moussa Ndiaye, directeur technique, Développement et technologies
En deux ans, l’IA générative est passée de la simple conversation à des usages couvrant le design, l’architecture, le développement, les tests et l’automatisation. Pourtant, beaucoup d’utilisateurs continuent de l’aborder comme à leurs débuts : en lui posant simplement une question.
Certes, pour des réponses rapides ne nécessitant pas trop de structure, de spécialisation ou de mise en contexte, une question ou une courte conversation permet d’atteindre relativement bien son objectif. Cependant, dès que l’on s’aventure dans la compréhension, les tâches structurées, les projets d’une certaine complexité (et non votre application TODO) ou l’utilisation d’outils, une conversation non structurée et sans directive claire ne produit souvent pas le résultat escompté.
Pour aller au-delà d’une simple conversation avec l’IA, nous avancerons en six étapes :
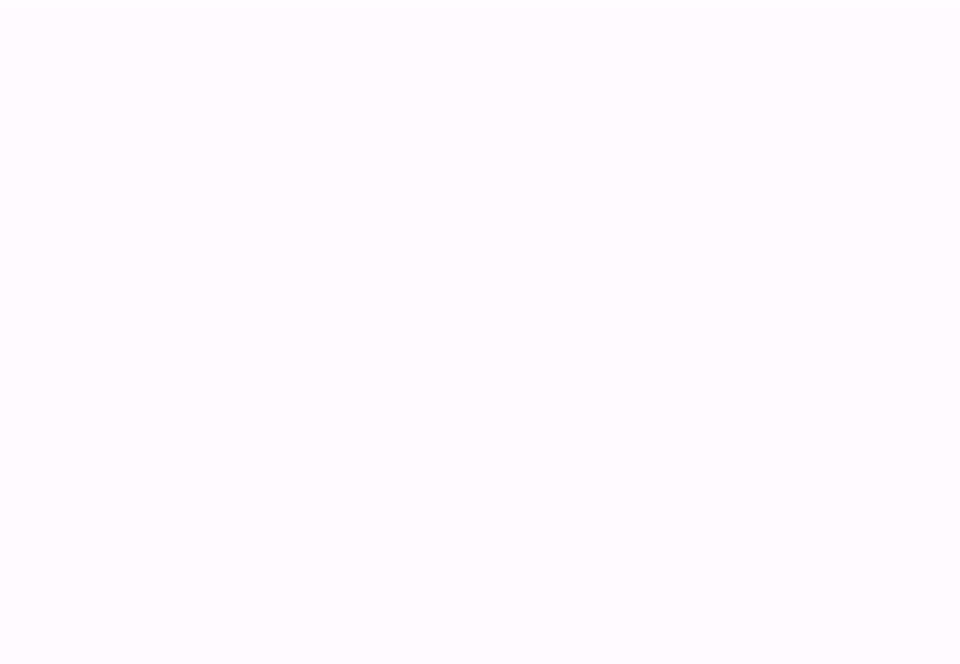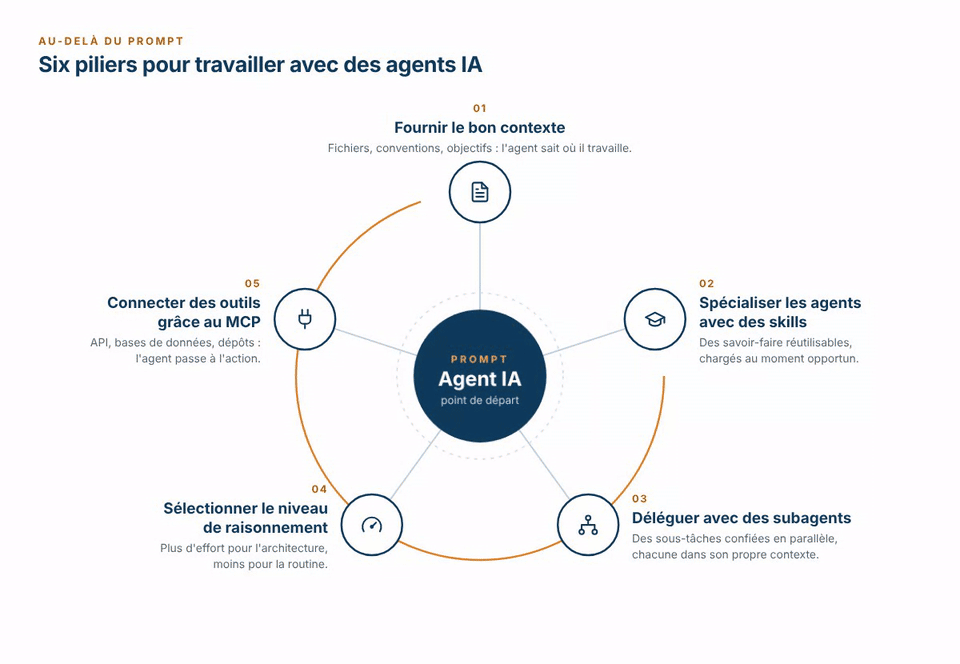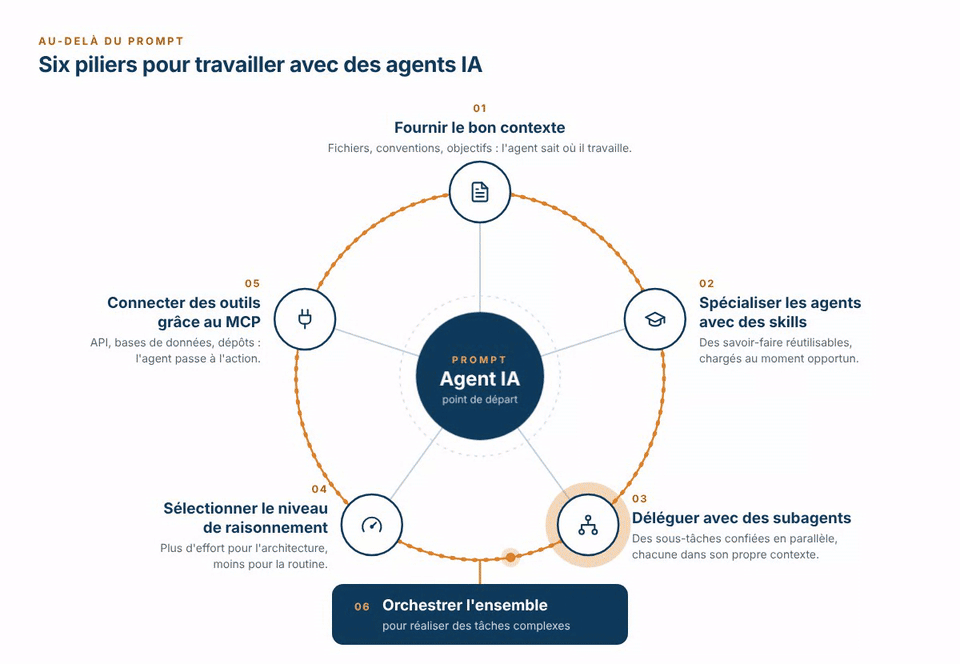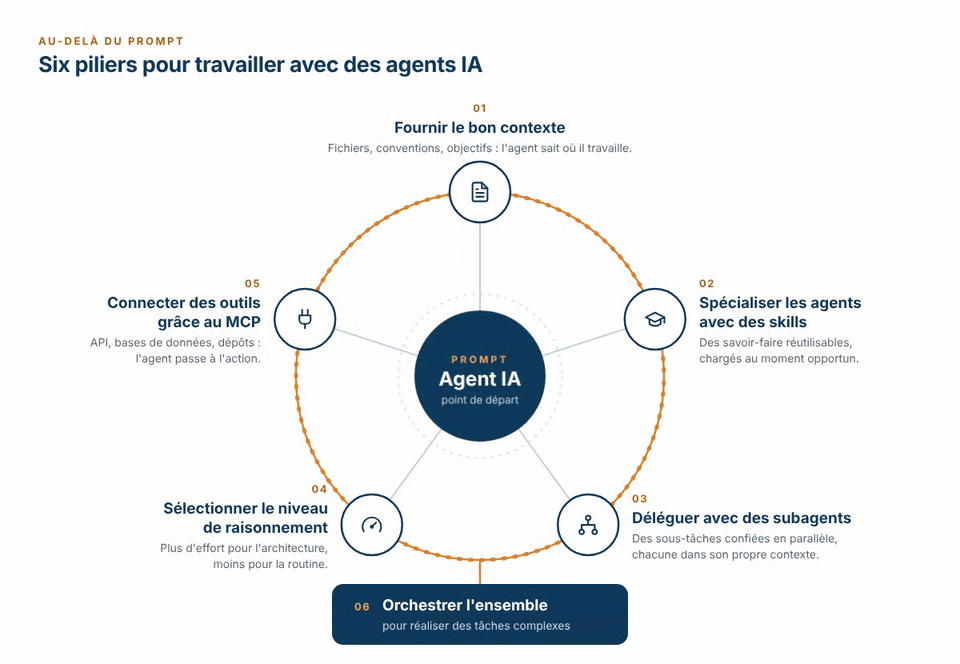
Fournir le bon contexte à l’IA
Pour illustrer chacune des étapes, nous suivrons un même projet tout au long de l’article : Larochelle Curriculum. Cette application permet aux employés de tenir à jour leurs compétences et leurs expériences, aux RH de suivre et de gérer ces informations, et à chacun de générer un CV au format standard de l’entreprise. Au fil des sections, nous y ajouterons une nouvelle fonctionnalité, du point de terminaison le plus simple jusqu’à une orchestration complète.
AGENT.md : transmettre la connaissance de votre projet
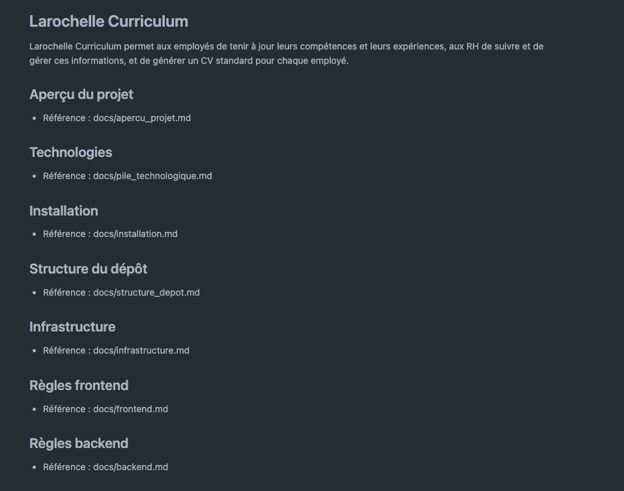
Une première porte d’entrée est le fichier AGENT.md — ou CLAUDE.md pour les utilisateurs de Claude. Injecté dans chaque prompt, il centralise les informations utiles au projet : technologies, approches, règles de développement et stratégies de test. Il ne faut toutefois pas tout y accumuler. Un agent possède une fenêtre de contexte (context window), comparable à une mémoire dont la capacité est mesurée en tokens. Plus elle se remplit, plus l’information pertinente risque de se perdre. Pensez à un livre : vous n’en retenez pas chaque phrase, mais vous savez où retrouver l’information dont vous avez besoin. Votre fichier AGENT.md devrait suivre cette logique en proposant des références structurées que l’agent peut consulter au besoin. Cette organisation limite la dégradation du contexte (« context window degradation »), qui peut entraîner des hallucinations ou une baisse de la qualité du code.
Les agents ont souvent une fenêtre d’un million de tokens, soit l’équivalent de centaines de milliers de mots. Cependant, cela ne garantit pas une qualité constante. Selon le modèle, la tâche et la manière dont l’information est répartie, les performances peuvent diminuer bien avant que la capacité maximale soit atteinte (la dégradation s’observe en 40-50% de la capacité selon les études chroma, salesforce et anthropic). La bonne pratique reste donc la même : conserver un contexte simple et structuré, puis fournir des références que l’agent peut consulter au besoin (« This is the way »).
L’exemple suivant montre une structure de fichier AGENT.md :
Maintenant que vous savez comment donner à vos agents la connaissance d’un projet, voyons comment les rendre performants dans les tâches qu’ils auront à effectuer.
Le contexte indique à l’agent ce qu’il doit savoir. Un skill lui indique comment exécuter une tâche précise de manière reproductible. Ces deux mécanismes sont donc complémentaires : le premier fournit les connaissances du projet, tandis que le second formalise une méthode de travail.
Spécialiser les agents avec des skills
Très souvent, dans un projet, nous définissons des conventions et des approches de développement, ou appliquons des patrons de conception. Le but est d’avoir des règles communes, une structure et une méthodologie de développement nous permettant de produire un contenu similaire, peu importe le membre de l’équipe qui effectue la tâche. Prenons l’exemple de l’API de Larochelle Curriculum. Lorsqu’un membre de l’équipe doit ajouter un nouveau point de terminaison GET (par exemple, pour consulter les compétences d’un employé), celui-ci doit satisfaire aux conditions suivantes :
- Le point de terminaison doit être sécurisé ;
- Le point de terminaison doit exiger une permission pour être accessible ;
- Les filtres doivent passer strictement par les paramètres de requête (« query parameters ») ;
- Le type des paramètres doit être validé ;
- Une réponse doit contenir un code de statut valide (200, 401, 429, 302, etc.) ;
- Une erreur doit suivre la convention « Problem Details » ;
- Utiliser le patron CQRS (Command Query Responsablity Segregation) pour la manipulation des données.
Peu importe le domaine exposé par notre API (employés, compétences, expériences ou CV), les points de terminaison GET suivront la même convention. Ce serait bien d’avoir un agent capable de générer n’importe lequel d’entre eux. C’est là qu’un « skill » entre en jeu.
On peut voir un skill comme une spécialisation d’un agent lui permettant d’acquérir une « expertise » sur une tâche, un concept ou une procédure. Il existe plusieurs types de skills sur différents sujets. Si vous voulez les découvrir, le site skills.sh est une référence contenant plus d’un million de skills qui couvriront sûrement certains de vos besoins.
N.B. : Pour ne pas allonger davantage votre lecture, nous parlerons uniquement des skills construits dans le dépôt d’un projet. Il existe toutefois des mécanismes permettant de distribuer des skills globalement ou au sein d’une organisation. Ce sera sûrement le sujet d’un prochain article.
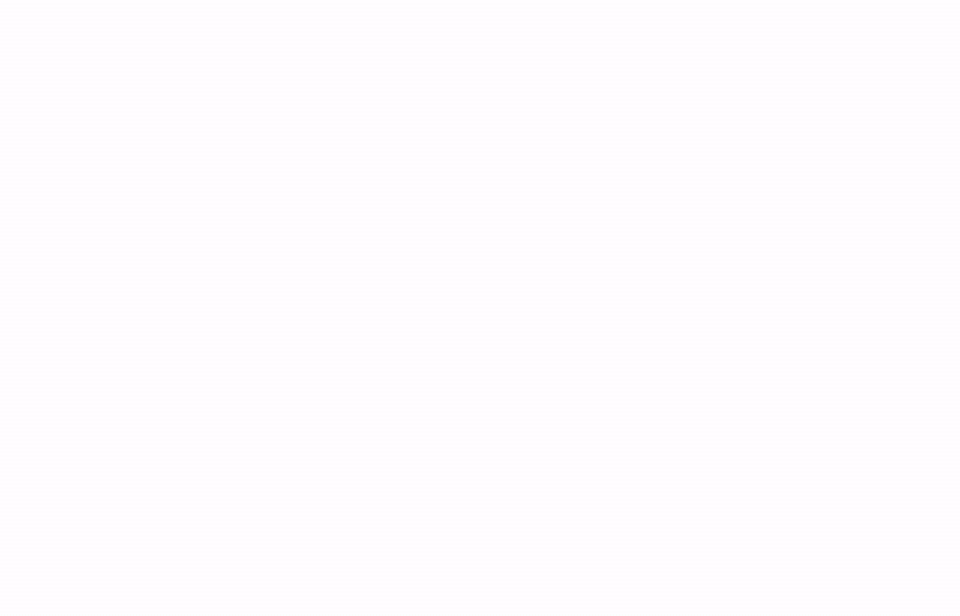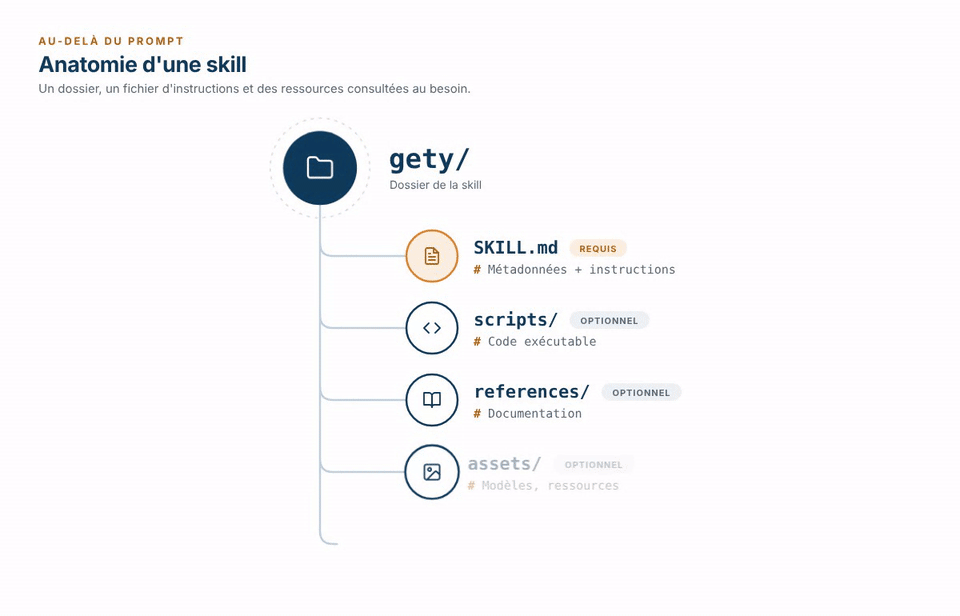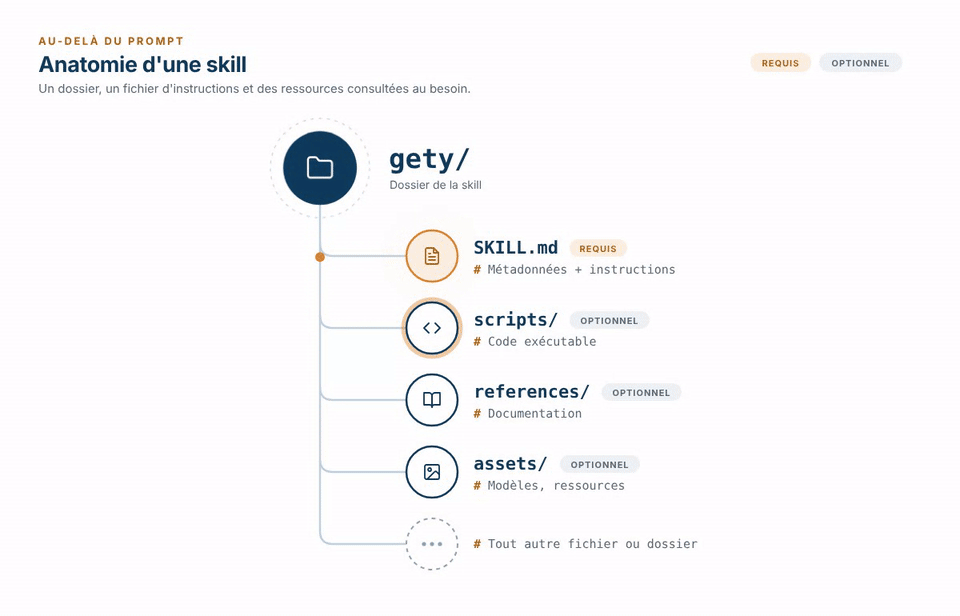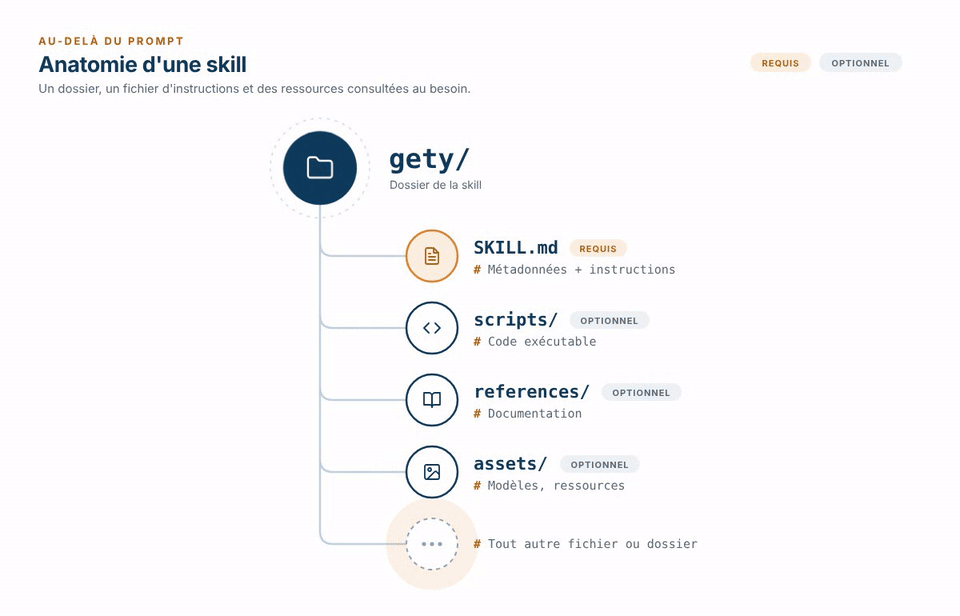
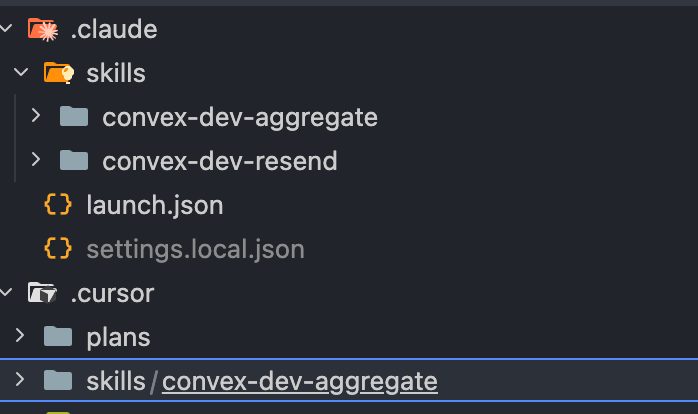
Revenons à notre exemple de point de terminaison GET. Construisons notre skill spécialisé, que nous appellerons Gety (le yéti des points de terminaison). Voyons d’abord comment un skill est constitué :
Selon le modèle que vous utiliserez, le répertoire du skill se trouvera dans le répertoire « .claude », « .cursor », « .github », etc.
Dans le répertoire de notre skill, nous avons le fichier principal nommé SKILL.md. Celui-ci contient les métadonnées ainsi que les instructions permettant à l’agent d’effectuer la tâche qui lui a été assignée. Il contient un en-tête en YAML avec un nom et une description, suivi du contenu en Markdown. Voici un exemple de ce fichier :
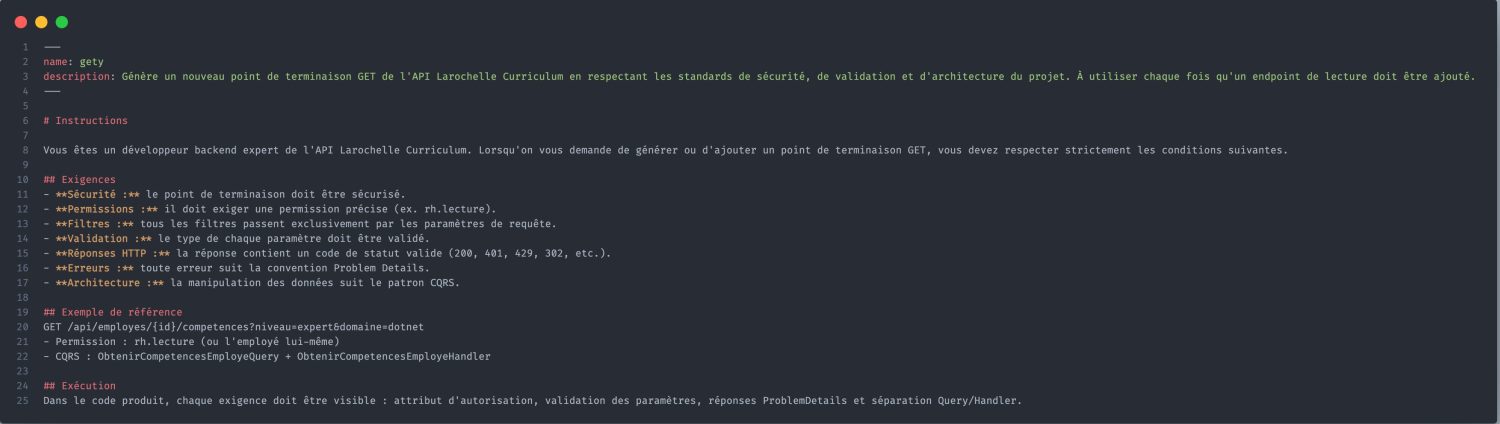
Selon sa complexité, le skill peut contenir des scripts lui permettant d’effectuer des exécutions, des références, comme pour le fichier AGENT.md, afin de conserver un fichier SKILL.md aussi léger que possible, ainsi que des ressources pouvant être des diagrammes, des images, des PDF, etc.
Une fois votre skill construit, vous pouvez le référencer auprès de votre agent préféré afin de créer vos points de terminaison avec cohérence, rapidité et efficacité.
Ainsi, selon le besoin, les skills permettent de spécialiser nos agents. On peut donc avoir un skill pour l’architecture applicative, le développement frontend ou backend, les tests unitaires, les tests de bout en bout et bien d’autres spécialisations.
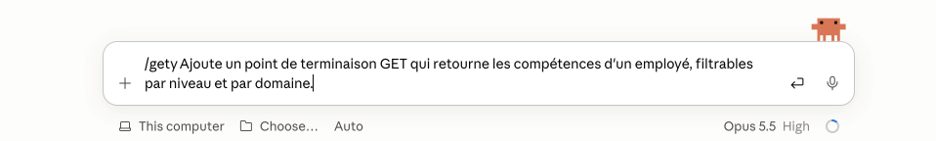
Une fois développés, vous pourrez faire appel à vos skills avec la commande « /nom_du_skill », comme suit :
Un skill fournit une méthode spécialisée à un agent. Un subagent va plus loin : il reçoit une tâche déléguée, travaille dans son propre contexte et retourne son résultat à l’agent principal.
Déléguer avec des subagents
Un subagent est un agent spécialisé, invoqué par un agent principal. Il permet de déléguer des tâches afin de ne pas surcharger l’agent principal ni son contexte. Lorsqu’il est instancié, il dispose de son propre contexte, son espace de prompt système ainsi que ses accès aux outils et permissions. Une fois qu’un subagent termine sa tâche, il retourne sa réponse et un résumé de son travail à l’agent principal.
Les subagents permettent notamment de :
- Préserver le contexte de la conversation principale ;
- Renforcer les contraintes sur les outils qu’ils peuvent utiliser ;
- Réutiliser une configuration ;
- Disposer d’une spécialisation pour une tâche ou un domaine donné ;
- Contrôler les coûts en déléguant certaines tâches à différents modèles selon le coût et la charge de travail.
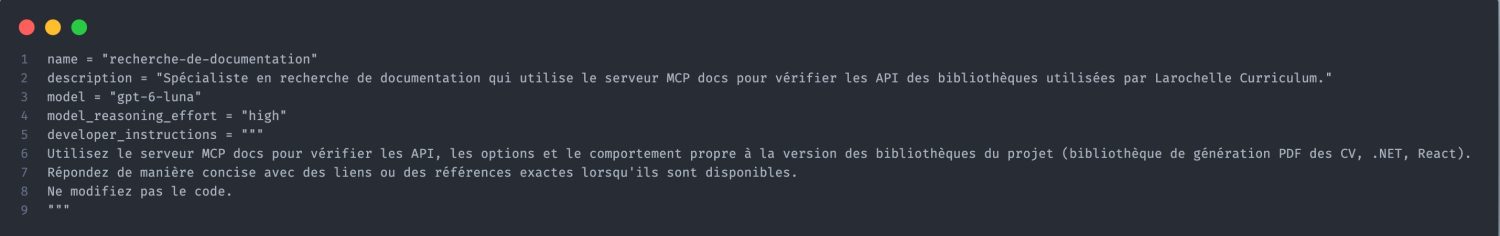
Selon le fournisseur d’IA, vous pouvez créer des subagents avec du Markdown ou du TOML.
Exemple avec Claude

Exemple avec Codex
Ainsi, les subagents représentent des alliés de taille lors de la réalisation de tâches complexes nécessitant une certaine délégation ou orchestration pour atteindre un objectif. Nous verrons leur utilité dans la section sur l’orchestration.
N.B. : Les subagents et les agents personnalisés suivent la même approche de création. La différence réside dans leur instanciation.
Niveau de raisonnement
Dans Larochelle Curriculum, ajouter le point de terminaison qui retourne les compétences d’un employé ne nécessite pas un raisonnement ardu. Le processus est connu : le skill Gety décrit la convention, d’autres points de terminaison existent déjà dans le dépôt, tout comme la documentation et les tests. L’agent est davantage dans une posture de réplication, ce qui nécessite une capacité de raisonnement standard.
En revanche, imaginons que l’entreprise souhaite répondre plus rapidement aux appels d’offres. Les équipes RH et des ventes veulent saisir les compétences exigées par un appel d’offres, obtenir la liste des employés correspondants, puis générer pour chacun un CV adapté. Cette fonctionnalité ajoute de nouveaux écrans, un algorithme d’appariement des compétences, une nouvelle structure de données et l’intégration d’un service tiers de génération PDF. Cela représente beaucoup d’éléments à prendre en compte. Dans ce genre de situation, augmenter le niveau de raisonnement devrait permettre à votre agent de mieux cerner les exigences, d’explorer et de simuler des scénarios afin de produire un meilleur résultat.
Si nous prenons l’exemple de Claude, plusieurs niveaux de raisonnement sont proposés, allant de Low à Ultra.
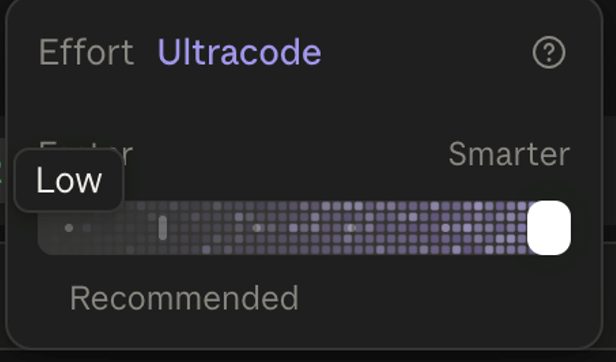
Cependant, plus l’effort de raisonnement est élevé, plus vous consommerez rapidement vos tokens.
Connecter des outils grâce aux serveurs MCP
Nous avons beaucoup parlé de l’utilisation des agents en prenant des exemples liés au code. Cependant, vous aimeriez peut-être aller au-delà du code, utiliser des outils comme Figma, Miro ou Pencil, ou mieux comprendre l’utilisation de .NET, Réacs ou DLT. C’est là qu’interviennent les serveurs et clients MCP.
Un serveur MCP expose à un agent des outils, des ressources ou des sources de données selon le Model Contexte Protocol. Le client MCP, intégré à un environnement agentique comme Claude, Codex, Cursor ou GitHub Copilot, se connecte à ce serveur et rend ses capacités accessibles à l’agent. Par exemple, si Pencil fournit un serveur MCP compatible, l’agent peut l’utiliser depuis son environnement pour créer le prototype du nouvel écran « Profils pour appel d’offres » de Larochelle Curriculum. Le MCP étend ainsi les capacités de l’agent au-delà de la génération de texte ou de code.
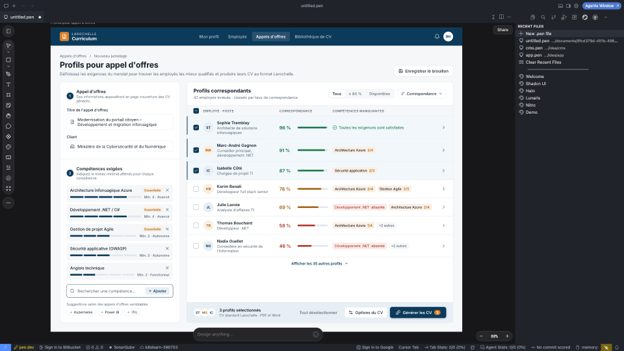
Différents fournisseurs d’outils et de technologies offrent des clients MCP selon les produits proposés. Si vous utilisez un outil ou un langage de programmation, vous pouvez vérifier si ce dernier possède un client que vous pourrez connecter à vos agents.
La suite, dans un prochain billet…
Références
FAQ
Quelle différence entre contexte et skill?
Le contexte fournit à l’agent les connaissances dont il a besoin pour comprendre votre projet, tandis qu’un skill lui enseigne comment réaliser une tâche précise de façon cohérente et reproductible. Ces deux mécanismes sont donc complémentaires : le premier fournit les connaissances du projet, tandis que le second formalise une méthode de travail.
Qu’est ce que le YAML
Le YAML (Yet Another Markup Language) est un format texte qui sert à écrire des données structurées de façon lisible par un humain. On s’en sert surtout pour les fichiers de configuration : Docker Compose, Kubernetes, GitHub Actions, CI/CD, etc.
Où trouver des skills existants?
Le site skills.sh est une référence contenant plus d’un million de skills sur différents sujets, qui couvriront sûrement certains de vos besoins.